El riesgo letal de las alucinaciones en el sector corporativo
En el transcurso del último par de años, el mundo presenció asombrado cómo los Grandes Modelos de Lenguaje (LLMs, por sus siglas en inglés) como GPT-4, Claude o Gemini irrumpían en nuestras pantallas. Estas inteligencias artificiales demostraron una capacidad casi mágica para redactar correos, componer poesía, estructurar código y resumir libros enteros con una gramática impecable.
Inmediatamente, los CEOs y directores de tecnología del mundo entero tuvieron la misma epifanía: "Si conecto este motor de inteligencia artificial a la base de datos de mi empresa, podré automatizar el 80% del trabajo de soporte al cliente y análisis documental."
Sin embargo, cuando las corporaciones intentaron implementar estos modelos de caja de manera directa, chocaron contra un muro de concreto llamado "alucinación". Las IA tradicionales sufren de un defecto crónico: están diseñadas para predecir la siguiente palabra de manera estadística y siempre quieren dar una respuesta plausible, incluso si tienen que inventar los datos para lograrlo.
Si un empleado de recursos humanos le pregunta a ChatGPT tradicional: "¿Cuál es nuestra política interna de viáticos para viajes internacionales del 2026?", la IA (que no fue entrenada con los documentos confidenciales de esa empresa) generará una respuesta muy corporativa, muy elocuente y completamente falsa. En un entorno empresarial —donde un error en un diagnóstico médico, un consejo legal inventado o una cifra financiera incorrecta puede costar millones de dólares o demandas judiciales— esta tasa de error es inaceptable.
Es exactamente aquí donde nace, como un salvavidas para la industria, la arquitectura RAG (Retrieval-Augmented Generation / Generación Aumentada por Recuperación).
¿Qué es exactamente RAG? Una analogía del mundo real
Para comprender RAG sin sumergirnos inmediatamente en tecnicismos de código, usemos una analogía.
Imagina que tienes a un juez de la Corte Suprema brillante, sumamente elocuente y experto en leyes (ese es el Modelo de Lenguaje de IA). Sin embargo, le haces una pregunta muy específica sobre el expediente confidencial de un caso local que ocurrió ayer. Por muy inteligente que sea el juez, no conoce el caso porque no leyó el expediente. Si lo obligas a responder, adivinará.
Ahora, imagina que le asignas un investigador asistente ultra rápido (ese es el sistema de Recuperación de RAG). Cuando haces la pregunta, el juez no responde de inmediato. En cambio, su asistente corre al archivo seguro de la corte, lee los millones de folios, extrae los cinco párrafos exactos que contienen los hechos del caso de ayer, y se los entrega en la mano al juez. Entonces, el juez lee la evidencia que le acaban de entregar, procesa la información con su intelecto superior, y te redacta una sentencia perfecta basada única y estrictamente en los folios proporcionados.
Ese es el corazón de la arquitectura RAG. Limita la creatividad del modelo de lenguaje atándolo al "suelo" de la información corporativa verídica.
La anatomía técnica de un flujo RAG
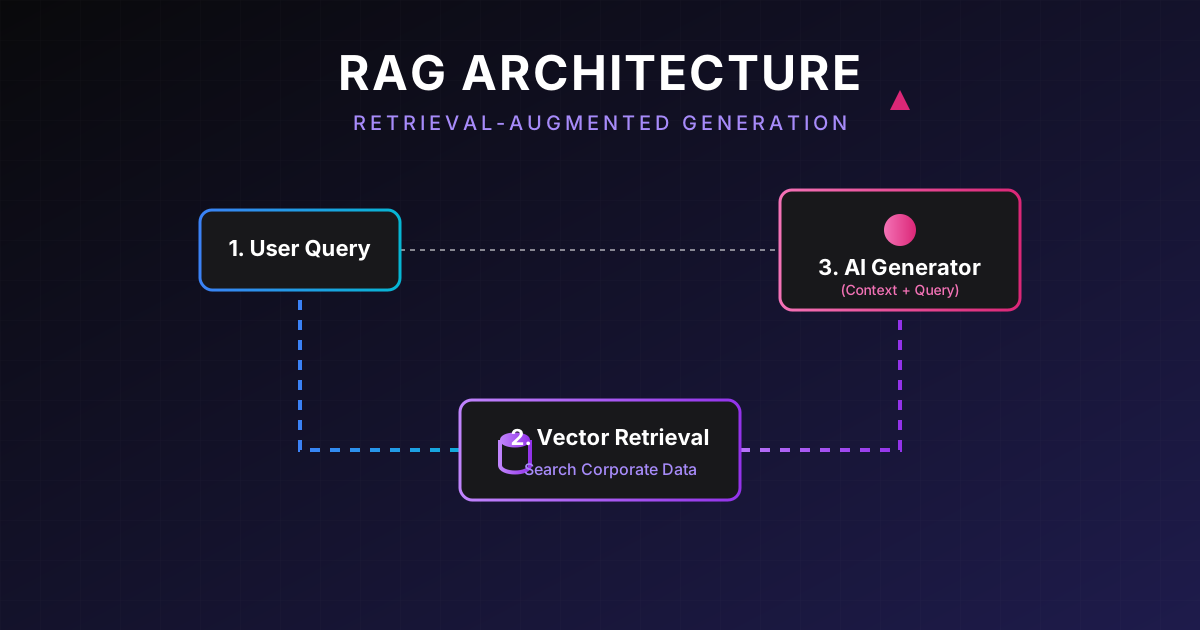
Implementar un flujo RAG moderno requiere coordinar tres piezas tecnológicas complejas de manera orquestada y en milisegundos.
1. La Ingesta de Datos y los Embeddings (El Archivo)
Antes de que un usuario haga una pregunta, la empresa debe preparar su información confidencial. Hablamos de PDFs de recursos humanos, manuales técnicos, correos electrónicos corporativos e historiales de tickets de soporte.
Esta información cruda se pasa a través de un modelo matemático especializado (Embedding Model) que convierte cada párrafo de texto en un vector de alta dimensión (una lista larguísima de números). Este vector captura el significado semántico del texto, no solo sus palabras. Si un texto habla de "perros", su vector estará numéricamente cerca de otro texto que hable de "cachorros", aunque no compartan exactamente la misma palabra. Estos vectores numéricos se guardan en una infraestructura nacida exclusivamente para este fin: una Base de Datos Vectorial (como Pinecone, Milvus o Azure AI Search).
2. La Búsqueda Semántica (Retrieval)
Cuando el empleado de la empresa introduce su consulta en la interfaz de chat (ej: "¿Cuántos días de vacaciones me corresponden por ley en el tercer año?"), el motor de RAG intercepta la pregunta antes de enviarla a la IA. Transforma esa pregunta en otro vector numérico y va a la Base de Datos Vectorial para realizar un cálculo matemático de similitud. La base de datos revisa millones de documentos y en microsegundos devuelve, digamos, los tres fragmentos de los manuales de recursos humanos más relevantes al concepto de "días de descanso".
3. La Generación Aumentada (Generation)
En el último paso, la arquitectura empaqueta todo. Toma la pregunta original del usuario y le concatena (pega) los tres fragmentos de información verídica recuperados de la base de datos corporativa. Se añade un "System Prompt" estricto que dice algo como: "Eres un asistente corporativo. Responde a la pregunta del usuario utilizando ÚNICAMENTE la información de contexto proporcionada a continuación. Si la respuesta no está en el contexto, di 'No poseo esa información'."
Finalmente, este inmenso paquete de texto se envía al Gran Modelo de Lenguaje. El modelo usa su inmensa capacidad cognitiva para leer el contexto, extraer la respuesta y redactarla de forma natural, amistosa y resumida para el usuario final.
El valor incalculable para las empresas
Las ventajas de utilizar la arquitectura RAG frente al enfoque de intentar reentrenar (Fine-Tuning) un modelo completo desde cero, son apabullantes.
Primero, es exponencialmente más barato. Reentrenar un modelo masivo con la data de tu empresa requiere tarjetas gráficas de altísimo costo (GPUs) e ingenieros altamente especializados en Machine Learning. RAG, en cambio, utiliza llamadas a APIs convencionales y bases de datos, lo que cualquier desarrollador de software tradicional puede implementar de forma económica.
Segundo, es dinámico y auditable. Si la política de la empresa cambia mañana, con RAG simplemente borras el PDF viejo de tu base de datos y subes el nuevo. El modelo responderá con la política nueva al instante. Si hubieras reentrenado un modelo, tendrías que volver a hacer todo el proceso matemático millonario. Además, como RAG extrae fragmentos reales de texto, puede citar sus fuentes: "Tienes 15 días de vacaciones según el Manual de Empleado 2026, página 44". Esto genera confianza extrema en los ejecutivos.
El futuro de los Administradores de IA
El ecosistema empresarial ya asimiló esta arquitectura. Productos como Microsoft 365 Copilot operan bajo una variación inmensamente compleja y robusta de RAG integrada con Microsoft Graph, recuperando tus correos, chats y hojas de Excel en tiempo real para generar respuestas útiles y seguras dentro de los límites de acceso de cada usuario.
Por ello, las empresas ya no están buscando ingenieros que diseñen nuevos algoritmos de inteligencia artificial. Están desesperadas por administradores, arquitectos de nube e ingenieros de datos que sepan construir canales seguros, gestionar bases de datos vectoriales, refinar estrategias de chunking (cómo cortar los documentos) y operar bases RAG a escala corporativa.
Comprender los fundamentos de la Generación Aumentada por Recuperación ya no es una curiosidad académica; es el lenguaje técnico universal de la presente década. Si tu ruta profesional se cruza de cualquier forma con los datos, la nube o el software corporativo, dominar RAG será el mayor salto cuántico de tu carrera.